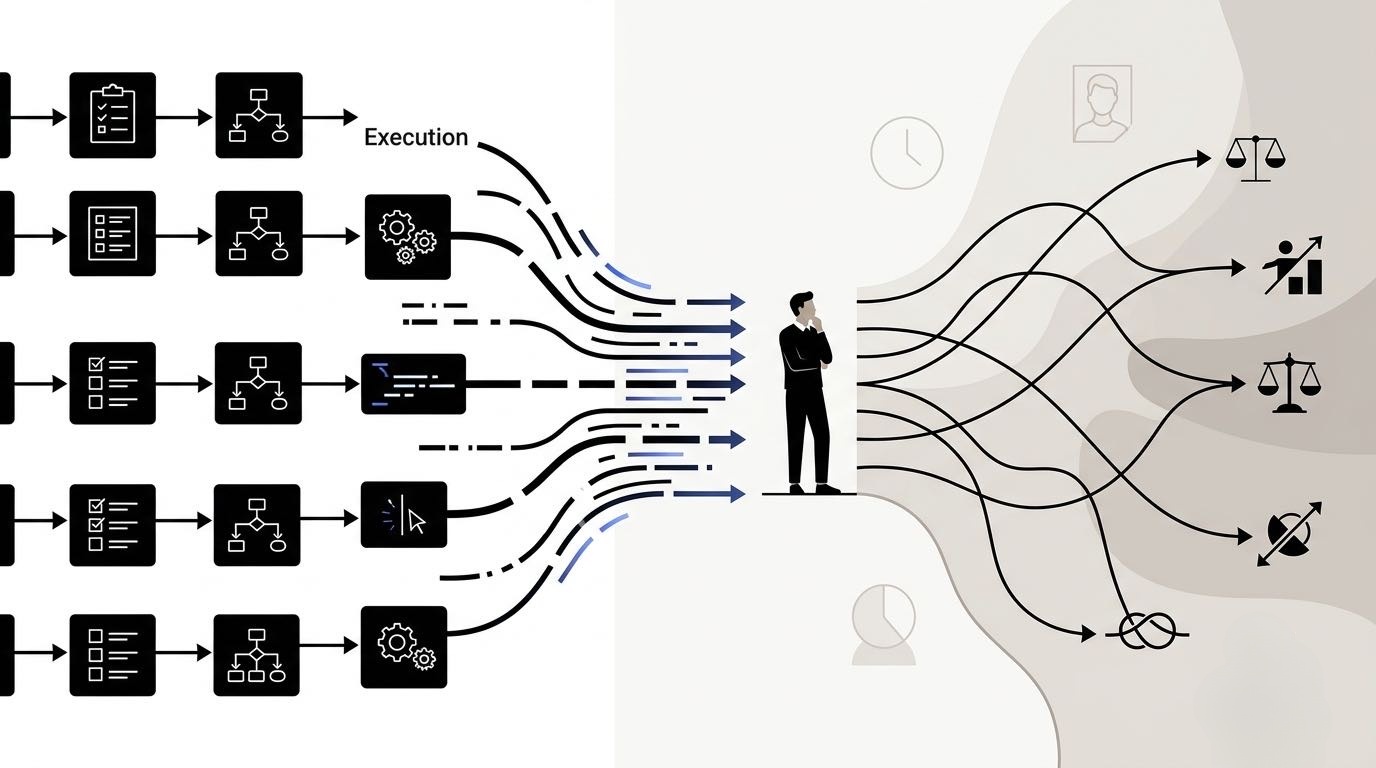
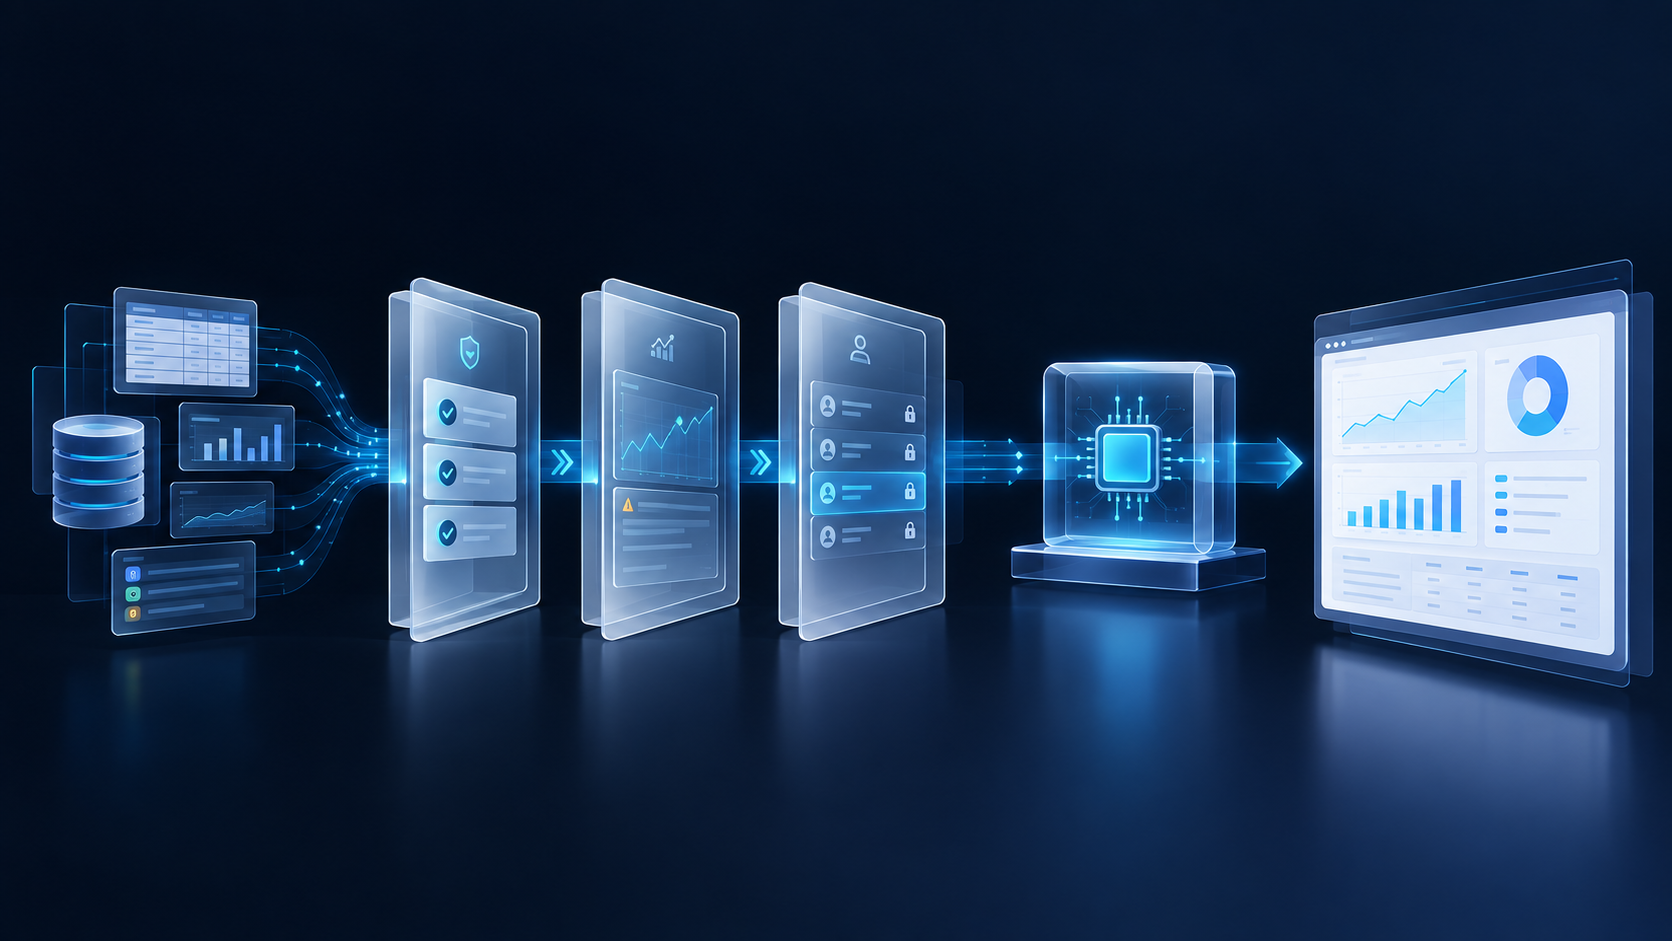
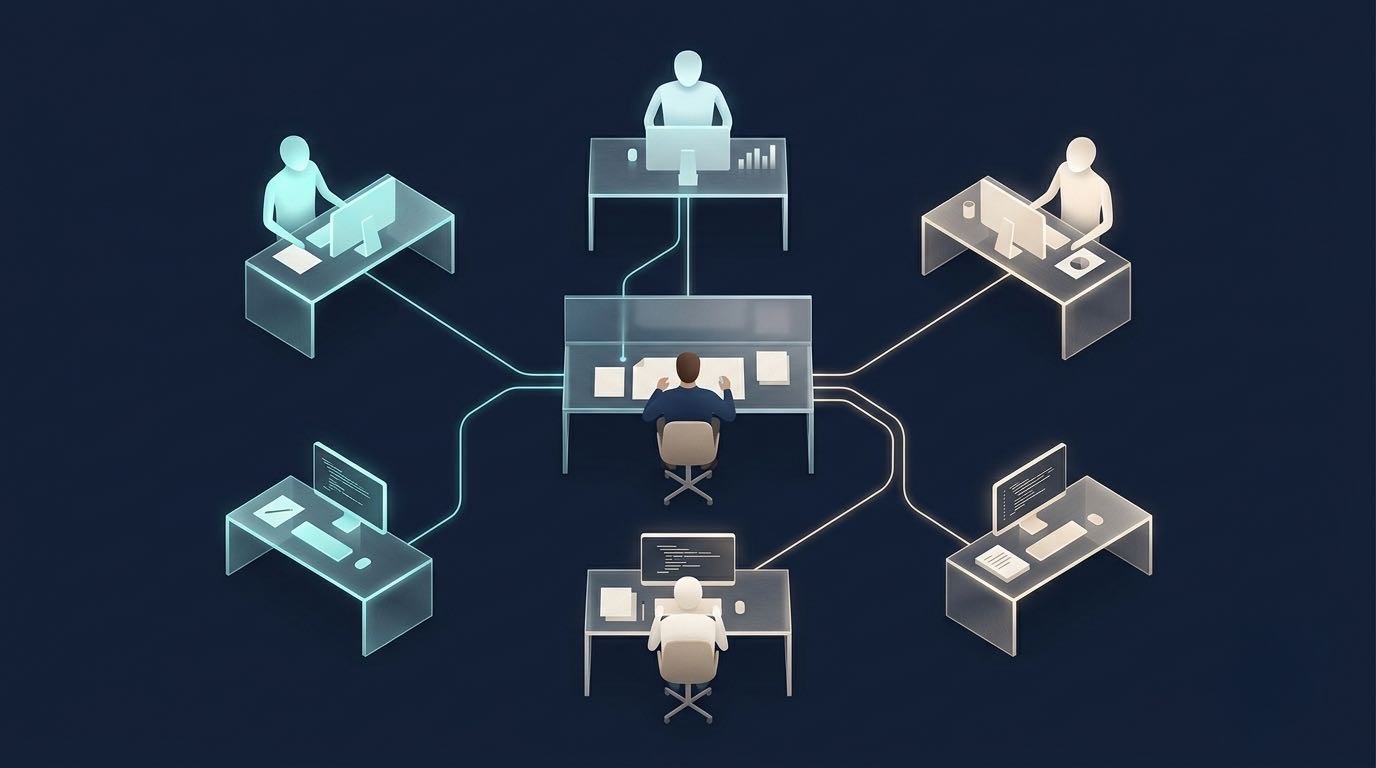
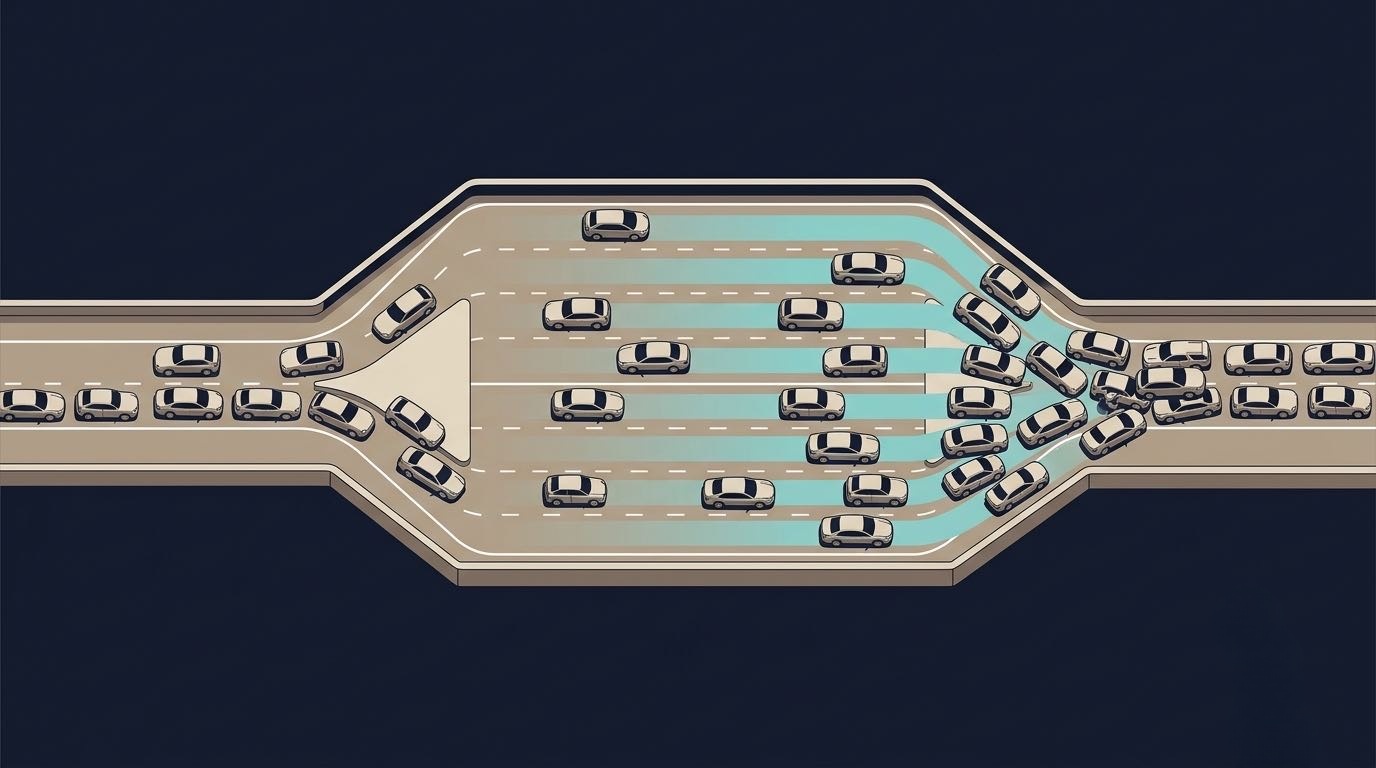
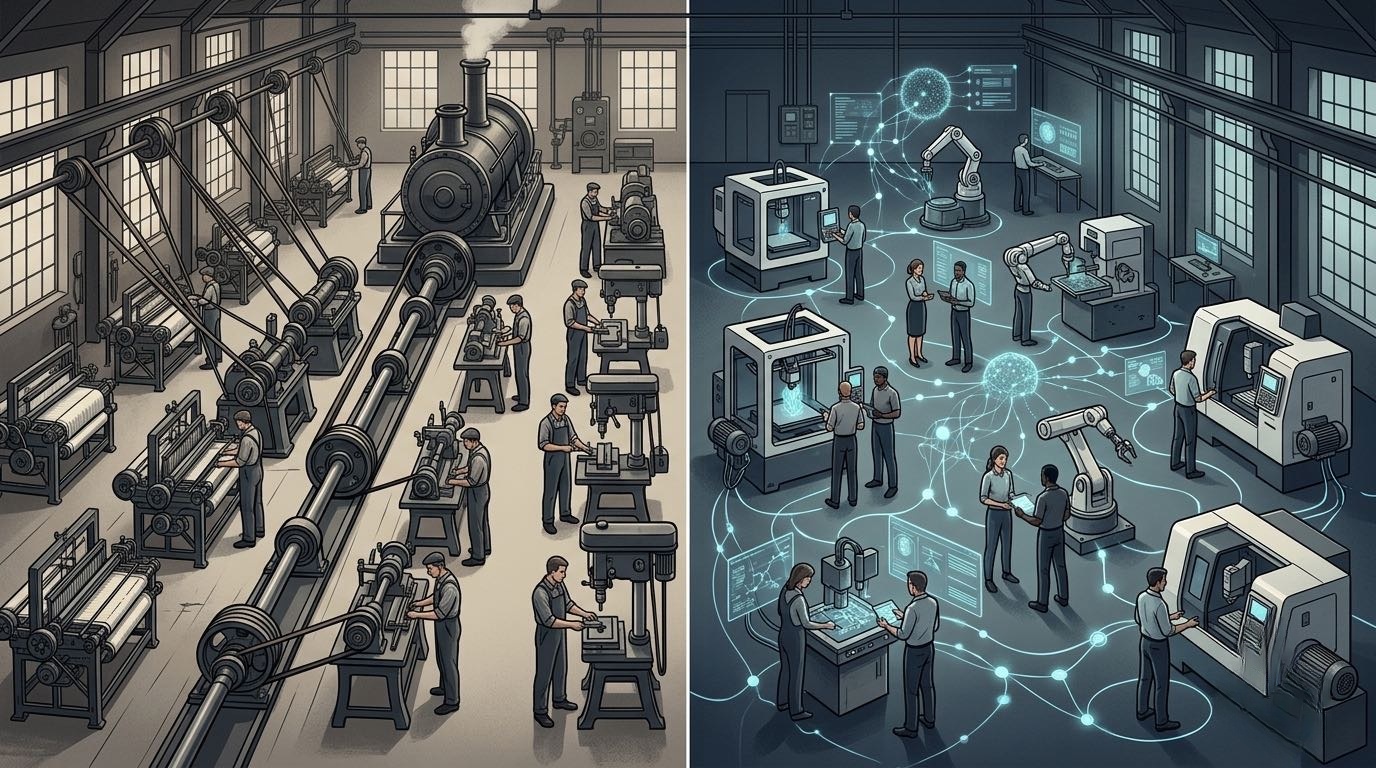
很多AI套壳产品就是把现在的电动机挂在原来的蒸汽机上,排队交接和审批流程本来就是围绕着人的有限注意力去设计的,往上挂一个AI,流程还是那个流程数字当然不会动,更麻烦的是转型期的数据往往先涨后跌,新流程的磨合成本是真金白银,产出却还没跟上,于是大量项目倒在最难看的那个坑里,被一群拿着报表、完全理性的人,合理地砍掉了。地基拆掉之后,组织会是怎样的,微软给了几个有意思的方向,智能变成”随取随用”的资源后,组织架构图开始让位给”工作流图”,团队不再按职能做区分,而是围着具体任务临时组建,打完就散;岗位在淡化,角色在崛起,每个人都得学会当”Agent 的管理者”。至少有一点现在基本能确认:这一波 AI 浪潮真正改变得不只是某个工具,而是围着旧生产方式长出来的那套组织结构、工作流程。技术趋近平权,动的是实现的门槛;实现成本一旦降到某个程度,组织原有的边界也会跟着松动。我们只有尽早的想明白这些问题并且能真正落实到自身所处的环境,根据自身环境为背景去搭建适合自身环境的流程,我们才能处于不掉队的位置。
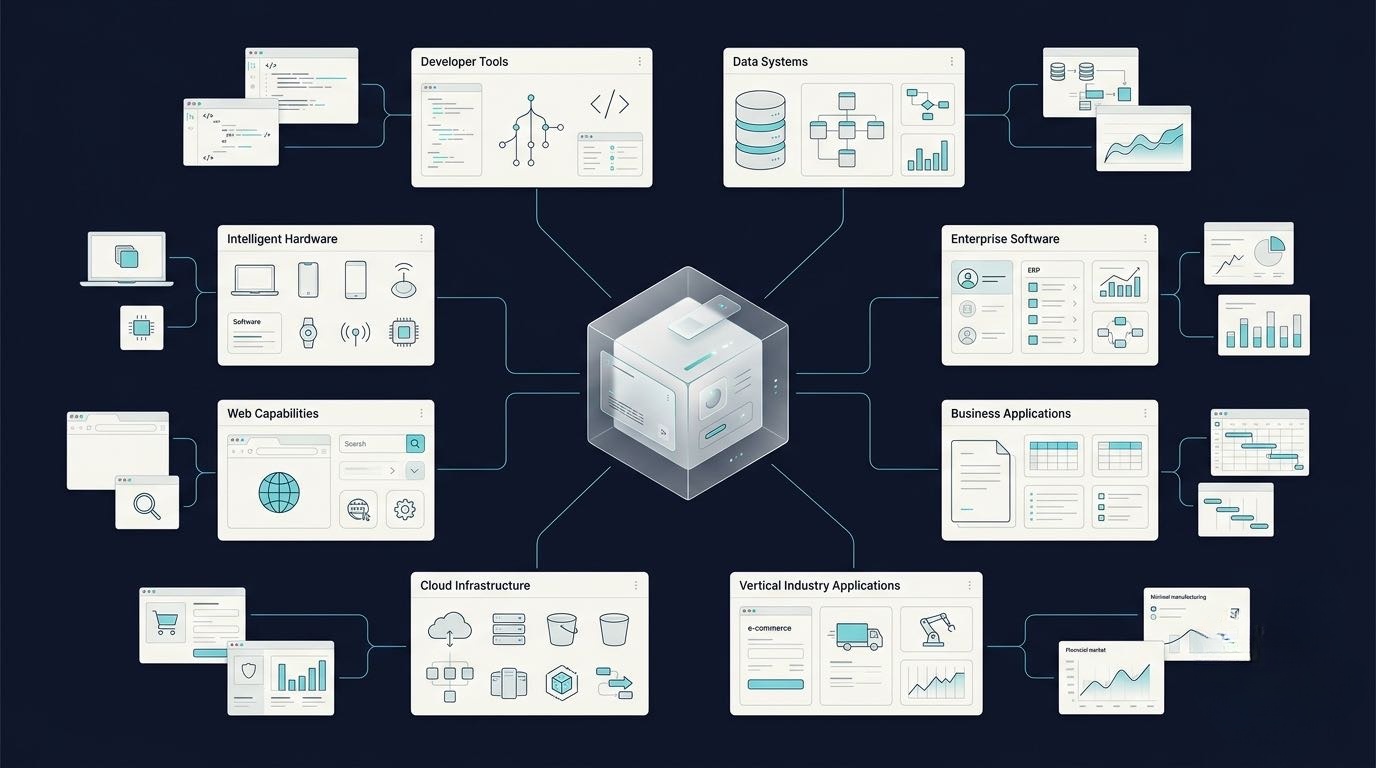
随着时间推进,真正产生工作收益的是Agent相关的能力,Agent接在真实业务系统里要面对的问题,比如说权限问题,事务和数据的一致性等问题光靠模型本身是不好解决的;而模型侧的玩家其实也不好过,模型厂商单纯给模型堆参数的收益会越来越低,Scaling Law的边际收益在放缓,互联网上的优质公开数据基本喂完了,想再拿增量高质量数据,渠道越来越少、成本越来越高。为了抢数据,头部公司已经在做”抢数据”的事情,美国一桩版权诉讼公开的文件里写着,某头部 AI 公司曾大规模采购实体书,拆掉书脊扫描,扫完把原书销毁,内部立项文件的目标一句话:”对全世界所有的书进行破坏性扫描”。这件事怎么定性我们不讨论,至少可以说明一个问题,轻易可以获取到的互联网上的公开数据快见底了,基模的军备竞赛在不远的将来只有极少数的玩家可以玩的起,对于大多数人来说模型会变的越来越像基础设施,不再有那么高的获取和使用成本。
技术平权改变最大的是让许多过去被技术门槛困住的有趣灵魂,就是现在经常被人说起的Vibecoding,看着各行各业零代码基础的人也可以手搓出很多极具美感和创意的产品,他们不用再花几个月去各种学习网站上看网课看资料去学习基础,对于我自己来说,大模型补齐了我作为产品经理在coding方面的短板,压低了我整合数据和资源的成本,和跨岗位的人拉齐了一定的认知差距,降低了我与其他人的一些信息差,以前打开 B 站还会搜”Python 入门、PyTorch 入门、Hadoop 底层原理……”,现在这些更像一个个技能包,开箱即用,我更多时候只需要想清楚:我到底要什么。AI提高的是人效,是从想法到成品的“交通效率”,想法变成现实的成本被极大程度的压缩,“定义有价值问题”这一步目前大模型还没办法完全替代有能力的人,所以这也是为什么大家都在说最先被替代的是做基础开发的人员,因为他们的劳动可复制性太强,一个公司内的资深架构师我相信还不至于现在就能轻易被大模型替代掉。每个人在垂直行业沉淀了多年的业务经验和对行业负责数据、业务问题的理解,对客户对人的长期洞察结论,这些才是大模型最难复刻的东西。
所以我的理解是,定义问题的能力、业务理解的深度和广度、判断什么值得做的见解会越来越值钱。这些软能力,没有被训练在大模型的参数里。工程实现的护城河一点点被填平,技术会趋近平权,而你对真实环境的灵感与品味,是模型压缩不掉的那部分稀缺资源。在这个行业做了这么多年,每当一轮风口来临时都会有一批人贩卖焦虑怕掉队,可当你放眼看那些穿越周期的人,眼光一致落在问题本身。模型会一直迭代,技术会一直进步,今天最先进的 AI 工具,两年后大概率就是人人能用的基础能力。真正值得长期积累的是提炼问题的眼光,业务一团糟时也能揪出关键;是把零散经验沉淀成规范、搭成稳定系统的能力;还有最重要的,敢跳出思维惯性、打破舒适圈去创造的勇气。



 发表于